推理引擎#
Xinference 对于不同模型支持不同的推理引擎。用户选择模型后,Xinference 会自动选择合适的引擎
llama.cpp#
Xinference 目前支持由 Xinference 团队开发的 xllamacpp 作为 llama.cpp 后端运行。llama.cpp 基于张量库 ggml 开发,支持 LLaMA 系列模型及其变体的推理。
警告
自 Xinference v1.5.0 起, xllamacpp 成为 llama.cpp 的默认选项, llama-cpp-python 被弃用;从 Xinference v1.6.0 开始, llama-cpp-python 已被移除。
自动选择 GPU wheel#
Added in version 3.0.
启用按模型虚拟环境且存在可用的 NVIDIA GPU 时,Xinference 会自动安装与检测到的 CUDA 版本线匹配的 xllamacpp wheel。CUDA 12.x 中的 12.8 及更高版本使用 cu128 wheel 索引,CUDA 13.x 使用 cu132 wheel 索引。仅 CPU 的主机和不受支持的 CUDA 版本继续使用 PyPI 中的默认 CPU wheel。此启动路径无需单独执行 xllamacpp GPU 安装命令。
请参考 llama.cpp 的 common.h 中 common_params 结构体定义设置参数。
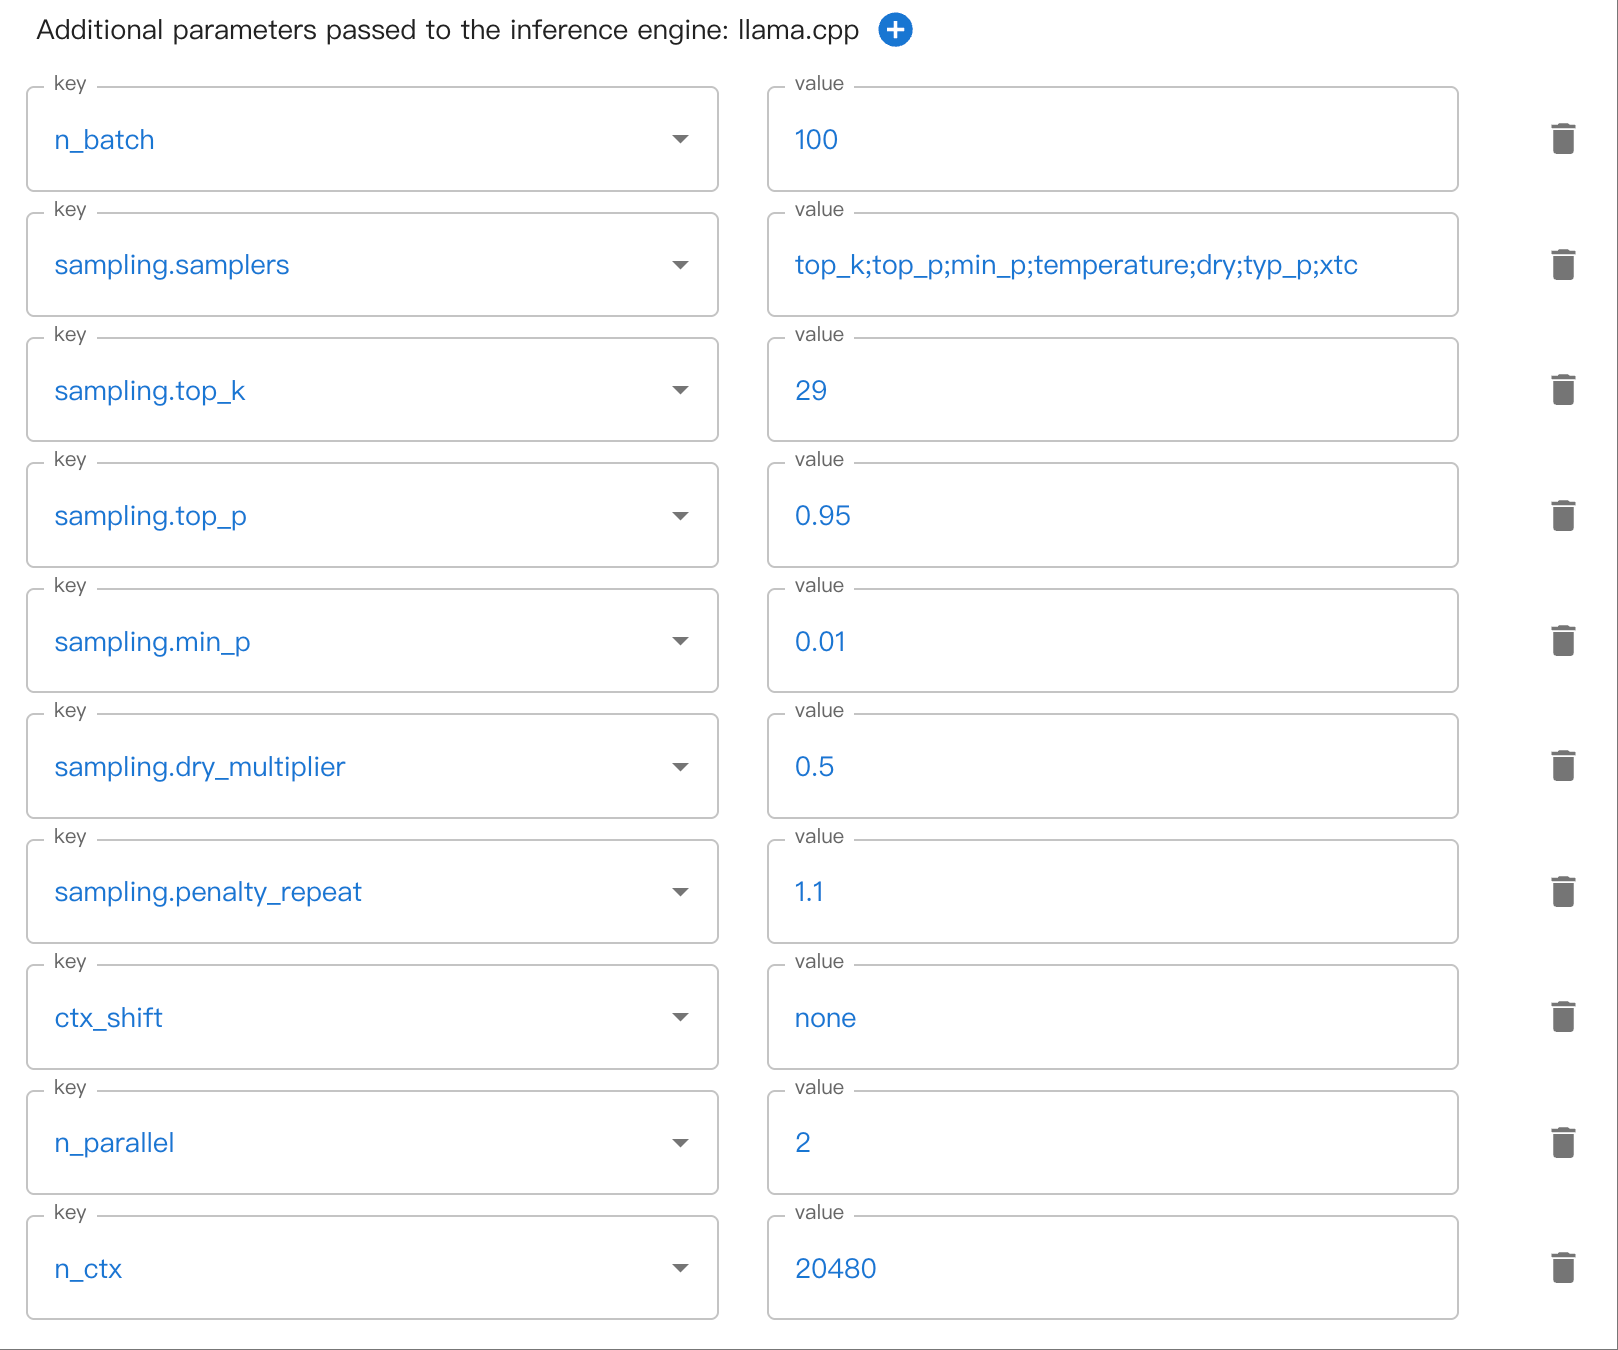
可能会有嵌套多层的参数。例如, sampling.top_k。请使用 . 来分割嵌套参数。
这里有一个在 WebUI 中设置嵌套 sampling 参数的例子:
自动 NGL#
Added in version v1.6.1: 自 v1.6.1 起,当未指定 n-gpu-layers(默认为 -1)时,将自动启用 GPU 层数估算功能。
这个特性可以为 llama.cpp 后端自动设置 GPU 层数(NGL)。请注意这并不是一个精确的计算,因此 -ngl 结果可能不是最优的,并且仍然可能遇到显存不足的错误。
目前自动 NGL 没有官方支持。请参考下面 issue 来了解更多详情:
我们的实现是基于 Ollama 的自动 NGL,但是有一些不同之处:
我们使用 xllamacpp 提供的设备信息。
我们删除了一些不常见的架构支持,这些架构下会使用默认计算逻辑。
如果自动 NGL 失败,我们会尝试全部加载到 GPU。
我们不支持多模态投影器内嵌到模型的 GGUF,这种格式的模型目前还处于实验阶段。
常见问题#
Server error: {'code': 500, 'message': 'failed to process image', 'type': 'server_error'}
服务端日志:
encoding image or slice...
slot update_slots: id  0 | task 0 | kv cache rm [10, end)
srv  process_chun: processing image...
ggml_metal_graph_compute: command buffer 0 failed with status 5
error: Internal Error (0000000e:Internal Error)
clip_image_batch_encode: ggml_backend_sched_graph_compute failed with error -1
failed to encode image
srv  process_chun: image processed in 2288 ms
mtmd_helper_eval failed with status 1
slot update_slots: id  0 | task 0 | failed to process image, res = 1
可能由于内存不足导致。你可以尝试减小
n_ctx解决。Server error: {'code': 400, 'message': 'the request exceeds the available context size. try increasing the context size or enable context shift', 'type': 'invalid_request_error'}
如果你正在使用 multimodal 功能,
ctx_shift会被默认关闭。请尝试增加n_ctx或者减小n_parallel以增加每个 slot 的 context 大小。Server error: {'code': 500, 'message': 'Input prompt is too big compared to KV size. Please try increasing KV size.', 'type': 'server_error'}
服务端日志:
ggml_metal_graph_compute: command buffer 1 failed with status 5
error: Insufficient Memory (00000008:kIOGPUCommandBufferCallbackErrorOutOfMemory)
graph_compute: ggml_backend_sched_graph_compute_async failed with error -1
llama_decode: failed to decode, ret = -3
srv  update_slots: failed to decode the batch: KV cache is full - try increasing it via the context size, i = 0, n_batch = 2048, ret = -3
可能由于 KV cache 创建失败导致。你可以通过减小
n_ctx或者增加n_parallel或者调节n_gpu_layers参数加载部分模型到 GPU 来解决。请注意,如果你只处理串行推理请求,增加n_parallel并不会带来性能提升。
transformers#
Transformers 支持绝大部分新出的模型。是 Pytorch 格式模型默认使用的引擎。
vLLM#
vLLM 是一个非常高效并且易用的大语言模型推理引擎。
vLLM 具有以下特点:
领先的推理吞吐量
使用 PagedAttention 高效管理注意力键和值记忆
对传入请求进行连续批处理
优化的 CUDA 内核
当满足以下条件时,Xinference 会自动选择 vLLM 作为推理引擎:
模型格式为
pytorch,gptq,awq,fp4,fp8或者bnb。当模型格式为
pytorch时,量化选项需为none。当模型格式为
awq时,量化选项需为Int4。当模型格式为
gptq时,量化选项需为Int3,Int4或Int8。操作系统为 Linux 并且至少有一个支持 CUDA 的设备
自定义模型的
model_family字段和内置模型的model_name字段在 vLLM 的支持列表中。
目前,支持的模型包括:
code-llama,code-llama-instruct,code-llama-python,deepseek,deepseek-chat,deepseek-coder,deepseek-coder-instruct,deepseek-r1-distill-llama,HuatuoGPT-o1-LLaMA-3.1,llama-2,llama-2-chat,llama-3,llama-3-instruct,llama-3.1,llama-3.1-instruct,llama-3.3-instruct,minicpm5-1b,tiny-llama,Yi,Yi-1.5,Yi-1.5-chat,Yi-1.5-chat-16k,Yi-200k,Yi-chatcodestral-v0.1,mistral-instruct-v0.1,mistral-instruct-v0.2,mistral-instruct-v0.3,mistral-large-instruct,mistral-nemo-instruct,mistral-v0.1,openhermes-2.5,seallm_v2Baichuan-M2,codeqwen1.5,codeqwen1.5-chat,deepseek-r1-distill-qwen,DianJin-R1,fin-r1,HuatuoGPT-o1-Qwen2.5,KAT-V1,marco-o1,qwen1.5-chat,qwen2-instruct,qwen2.5,qwen2.5-coder,qwen2.5-coder-instruct,qwen2.5-instruct,qwen2.5-instruct-1m,qwenLong-l1,QwQ-32B,QwQ-32B-Preview,seallms-v3,skywork-or1,skywork-or1-preview,vibethinker,XiYanSQL-QwenCoder-2504llama-3.2-vision,llama-3.2-vision-instructbaichuan-2,baichuan-2-chatInternLM2ForCausalLMqwen-chatmixtral-8x22B-instruct-v0.1,mixtral-instruct-v0.1,mixtral-v0.1cogagentglm-edge-chat,glm4-chat,glm4-chat-1mcodegeex4,glm-4vqwen3.8-maxseallm_v2.5orion-chatqwen1.5-moe-chat,qwen2-moe-instructCohereForCausalLMdeepseek-v2-chat,deepseek-v2-chat-0628,deepseek-v2.5,deepseek-vl2deepseek-prover-v2,deepseek-r1,deepseek-r1-0528,deepseek-v3,deepseek-v3-0324,Deepseek-V3.1,moonlight-16b-a3b-instructdeepseek-r1-0528-qwen3,qwen3minicpm3-4binternlm3-instructgemma-3-1b-itglm4-0414minicpm-2b-dpo-bf16,minicpm-2b-dpo-fp16,minicpm-2b-dpo-fp32,minicpm-2b-sft-bf16,minicpm-2b-sft-fp32,minicpm4Ernie4.5Qwen3-Coder,Qwen3-Instruct,Qwen3-Thinkingglm-4.5,GLM-4.6,GLM-4.7gpt-ossseed-ossQwen3-Next-Instruct,Qwen3-Next-ThinkingDeepSeek-V3.2,DeepSeek-V3.2-ExpMiniMax-M2,MiniMax-M2.5,MiniMax-M2.7GLM-4.7-Flashglm-5,glm-5.1,glm-5.2,glm-5.3DeepSeek-V4-Flash,DeepSeek-V4-Flash-0731,DeepSeek-V4-ProHy-MT2-1.8B,Hy-MT2-7BHy-MT2-30B-A3B
除 LLM 之外,vLLM 还可以用于部署 embedding 模型。名称以 bge、 gte、 text2vec、 m3e、 Qwen3 或 bce 开头的模型系列都可以通过 --model-engine vllm 启动——参见 嵌入。
在配备 NVIDIA GPU 的 Linux 系统上,vLLM 也可以作为部分文生图模型(例如 Qwen-Image、Z-Image-Turbo )的引擎,参见 图像引擎。这需要安装 vLLM-Omni 扩展,并使用主版本号和次版本号相同的 vLLM,例如 pip install 'vllm-omni==0.28.*' 'vllm==0.28.*'。
SGLang#
SGLang 具有基于 RadixAttention 的高性能推理运行时。它通过在多个调用之间自动重用KV缓存,显著加速了复杂 LLM 程序的执行。它还支持其他常见推理技术,如连续批处理和张量并行处理。
除了大语言模型,在配备 NVIDIA GPU 的 Linux 系统上,SGLang 也可以作为部分文生图模型(例如 Qwen-Image、Z-Image-Turbo )的引擎,参见 图像引擎。这需要安装支持扩散模型的 SGLang:pip install 'sglang[diffusion]>=0.5.20,<0.6'。
MLX#
MLX 提供在苹果 silicon 芯片上高效运行 LLM 的方式。在模型包含 MLX 格式的时候,推荐使用苹果 silicon 芯片的 Mac 用户使用 MLX 引擎。
MLX 也可以在 Apple 芯片上运行受支持的音频模型。Whisper 模型、F5-TTS 和 Kokoro-82M 可通过 --model-engine MLX 使用该引擎;参见 音频引擎。
推测解码#
有些模型配有小型草稿模型检查点,用来提前预测多个 token,再由目标模型一次验证。输出保持不变,解码速度则会提高。Gemma 4 将此称为多 token 预测(MTP),并为每种规格发布了对应的 *-it-assistant 草稿模型。
启动时传入 --enable_mtp true,即可下载模型规格中声明的草稿模型,并与目标模型一起运行:
xinference launch --model-name gemma-4 --model-engine vllm \
  --model-format pytorch --size-in-billions 12 --quantization none \
  --enable_mtp true
在 Web UI 中,对应选项位于 高级配置 → 推测解码 下,仅在所选格式和规格提供草稿模型时显示。
可选参数:
--num_speculative_tokens <n>:每轮提议的 token 数量,包含额外的奖励 token。未设置时,MLX 从草稿模型读取该值,使用其训练时的深度(Gemma 4 为4)。Gemma 4 在 llama.cpp、vLLM 和 SGLang 上使用相同的规格配置:E2B 为2,E4B 和 26B-A4B 为4,12B 和 31B 则取建议范围4-8的下限(4)。其他 llama.cpp 模型保留 xllamacpp 自身的默认值。--draft_quantization <quantization>:当模型规格声明了多个草稿模型转换版本时,指定使用哪一个。Gemma 4 12B 的 MLX 版本提供了八种。默认使用第一个声明的版本,也就是量化程度最低的版本:草稿模型本身很小,而量化会降低接受率,因此建议将量化后的目标模型与未量化的草稿模型配合使用。--draft_model_path <path>:使用本地草稿模型,替代模型规格中声明的版本。设置此参数会自动启用--enable_mtp true。
草稿模型的系列和规格必须与目标模型匹配,因为两者共享目标模型的 KV 缓存。不匹配的检查点会被拒绝,而不是在不提示的情况下影响结果。
引擎支持情况:
引擎 |
要求 |
说明 |
|---|---|---|
|
转换为包含 |
|
|
转换为 |
|
|
由 MLX 视觉引擎提供支持,该引擎也用于运行 Gemma 4 等多模态模型。加载模型时会检查草稿模型是否与目标模型匹配。 |
|
|
转换为 |
Transformers 引擎暂不支持:它运行自己的连续批处理循环,而不是调用 generate(),因此没有可接入草稿模型的位置。
何时能带来加速#
只有当草稿模型单步计算的开销相对于目标模型单步解码足够低时,推测解码才值得使用。草稿模型是一个小型稠密模型,其开销不会随目标模型变化,因此两者的开销比例决定了最终效果。对于混合专家模型,推测解码反而可能更慢,因为每个 token 只需读取激活的那部分参数:
gemma-4 MLX,4 位量化,M5 Pro |
不使用草稿模型 |
使用 MTP |
每轮接受的 token 数 |
|---|---|---|---|
31B(稠密模型,每个 token 读取 18.4 GB) |
14.9 tok/s |
31.0 tok/s (2.1 倍) |
4 个中接受 2.08 个 |
26B-A4B(MoE,每个 token 读取约 2.2 GB) |
73.2 tok/s |
65.9 tok/s(0.9 倍) |
4 个中接受 1.40 个 |
这个 0.83 GB 的草稿模型,其计算开销约为 31B 单步解码的 5%,却相当于 26B-A4B 单步解码的 39%。因此,在 MoE 模型上,一轮中的三步草稿计算就已超过一次普通解码的开销,而这一轮还要在接受率更低的情况下弥补这些开销。这里 MoE 模型的绝对速度仍然更快,只是没有足够空间再从推测解码中获益。
因此,长期启用前应先实测。问题并不在验证步骤本身:对于这两个模型,四个 token 的前向计算开销都只比单个 token 高约 40%。